默契 Moqi|让协作上下文跨 Agent 延续
一套从真实协作摩擦中生长出来的个人协作系统
为什么做
在使用多个 Agent 处理写作、研究与代码任务时,我反复遇到三个问题:同样的偏好需要重复解释;不同 Agent 的规则逐渐分叉;规则越写越多后反而被挤占真正用于任务的上下文。
我最初把它当作提示词问题,后来意识到,继续补充提示词只能增加信息,却不能解决维护和加载方式。问题因此被重新界定为规则如何加载、维护和持续同步。
我还注意到一个问题。有的 Agent 工具自带的记忆只是记录,把每次决策都记下来,像写流水账一样,却不区分哪些是一次性的做法、哪些是会复用的规则,哪些结论已经被推翻或更新。记录越积越多,可靠性却没有跟着提高,有时候反而会用已经被推翻的记忆回答我。这让我把关注点从「记得更多」转移到「记得更准」——问题不只是规则怎么加载和维护,还有记忆按什么粒度留、什么时候该失效。值得长期保留的不是每一次决策,而是会被反复调用的经验,并且它应该是可以动态更新的。
要解决什么
我要建立的不是一份更长的提示词,而是一套跨 Agent 延续、随协作方式持续演化的上下文体系:不同 Agent 从同一真实源读取协作边界,分层加载,我和 Agent 共同维护,关键改动由我最终确认。沉淀下来的是会复用的规则、更新的记忆和稳定的思维模式,而不是每一次决策。
运行机制
多个 Agent 通过各自的加载路径,调用同一份共享规则(AGENTS.md),接入常驻的个人上下文(self/,Memory 记录当前事实、Soul 记录稳定思维模式)与按需加载的细则(references/,只在相关任务读取)。任务中产生的值得跨会话保留的信息,经「对齐」机制由 AI 提议、我确认后,分流写入唯一真实源。
关键判断
上下文应按照使用频率和任务类型分层加载。
把所有内容都每轮常驻,这看似完整,实则同时增加无关上下文和维护负担。因此,真正需要区分的不是重要和次要规则,而是每轮必须生效与只在特定任务中需要。基于这个判断,我把系统拆成入口层、个人上下文和按需细则层,稳定边界保持常驻,审查、研究、代码等执行细则只在相应任务出现时加载。
规则应该成为人机共同维护、由人最终决策的动态契约。
静态规则会随着协作方式变化而过期,但让 AI 自由改写长期规则又会失去控制。为同时保留观察能力和决策权,我设计「对齐」机制,从每次协作中提取值得跨会话保留的信息,按类型进行分流(规则→主入口、事实→Memory、稳定模式→Soul、协作关系→Agent、按需细则→对应 reference),写入唯一真实源并保持克制更新。
不可逆操作必须由明确且不可协商的红线约束。
一次文件迁移中,AI 曾在目标尚未验证完整前删除源文件,导致文件丢失。这让我意识到,不可逆错误的代价并不对称,抽象的「谨慎操作」不足以约束模型的临场判断。因此,我按可逆性而非复杂度设定分类操作规则:读取、普通编辑和测试可以直接执行;删除、推送、改历史和生产变更必须事前确认,自动接受模式也不能跳过我的红线。
当前结果与验证
当前已接入 Codex、Claude Code、WorkBuddy、OpenCode 和 DeepSeek Harness 五个入口。它们经由各自的加载路径接入 Moqi,调用同一套协作规则,跨 Agent 协作不再需要重复解释。默契 Moqi 系统本身可持续演化,可通过任意一个 Agent 更新。
默契 Moqi 是一个复利工程。上下文供给决定 AI 能看见什么,反馈闭环决定它能自我修正到哪一步,沉淀下来的资产决定下一轮的起点有多高。它随我的认知和经历动态更新,逐渐积累成我的长期资产。
循环能转起来,前提是信息本身可被 AI 消费。鸭哥总结过一套「上中下三策」的实践框架:同一件事怎么处理,决定了 AI 能帮我多少——下策是让信息消失,人和 AI 都看不到;中策是记成只有人能看懂的形式,对 AI 仍然不友好;上策是先让 AI 能消费、再加工给人看。做会议记录或数据分析时,把分析过程、原始链接、失败原因和观察一并写进去,它才能接着往下做。
工具会换,今天用 Claude Code,明天可能是 Codex 或 WorkBuddy;模型也会一轮轮升级。但反馈闭环让 AI 能自我修正、上下文供给让它理解我的世界、资产积累让协作成本持续下降,这些不随工具和模型变化。用得越多、积累越厚,它就越懂我的项目、偏好和工作方式——越用越顺的飞轮,默契是它的载体。
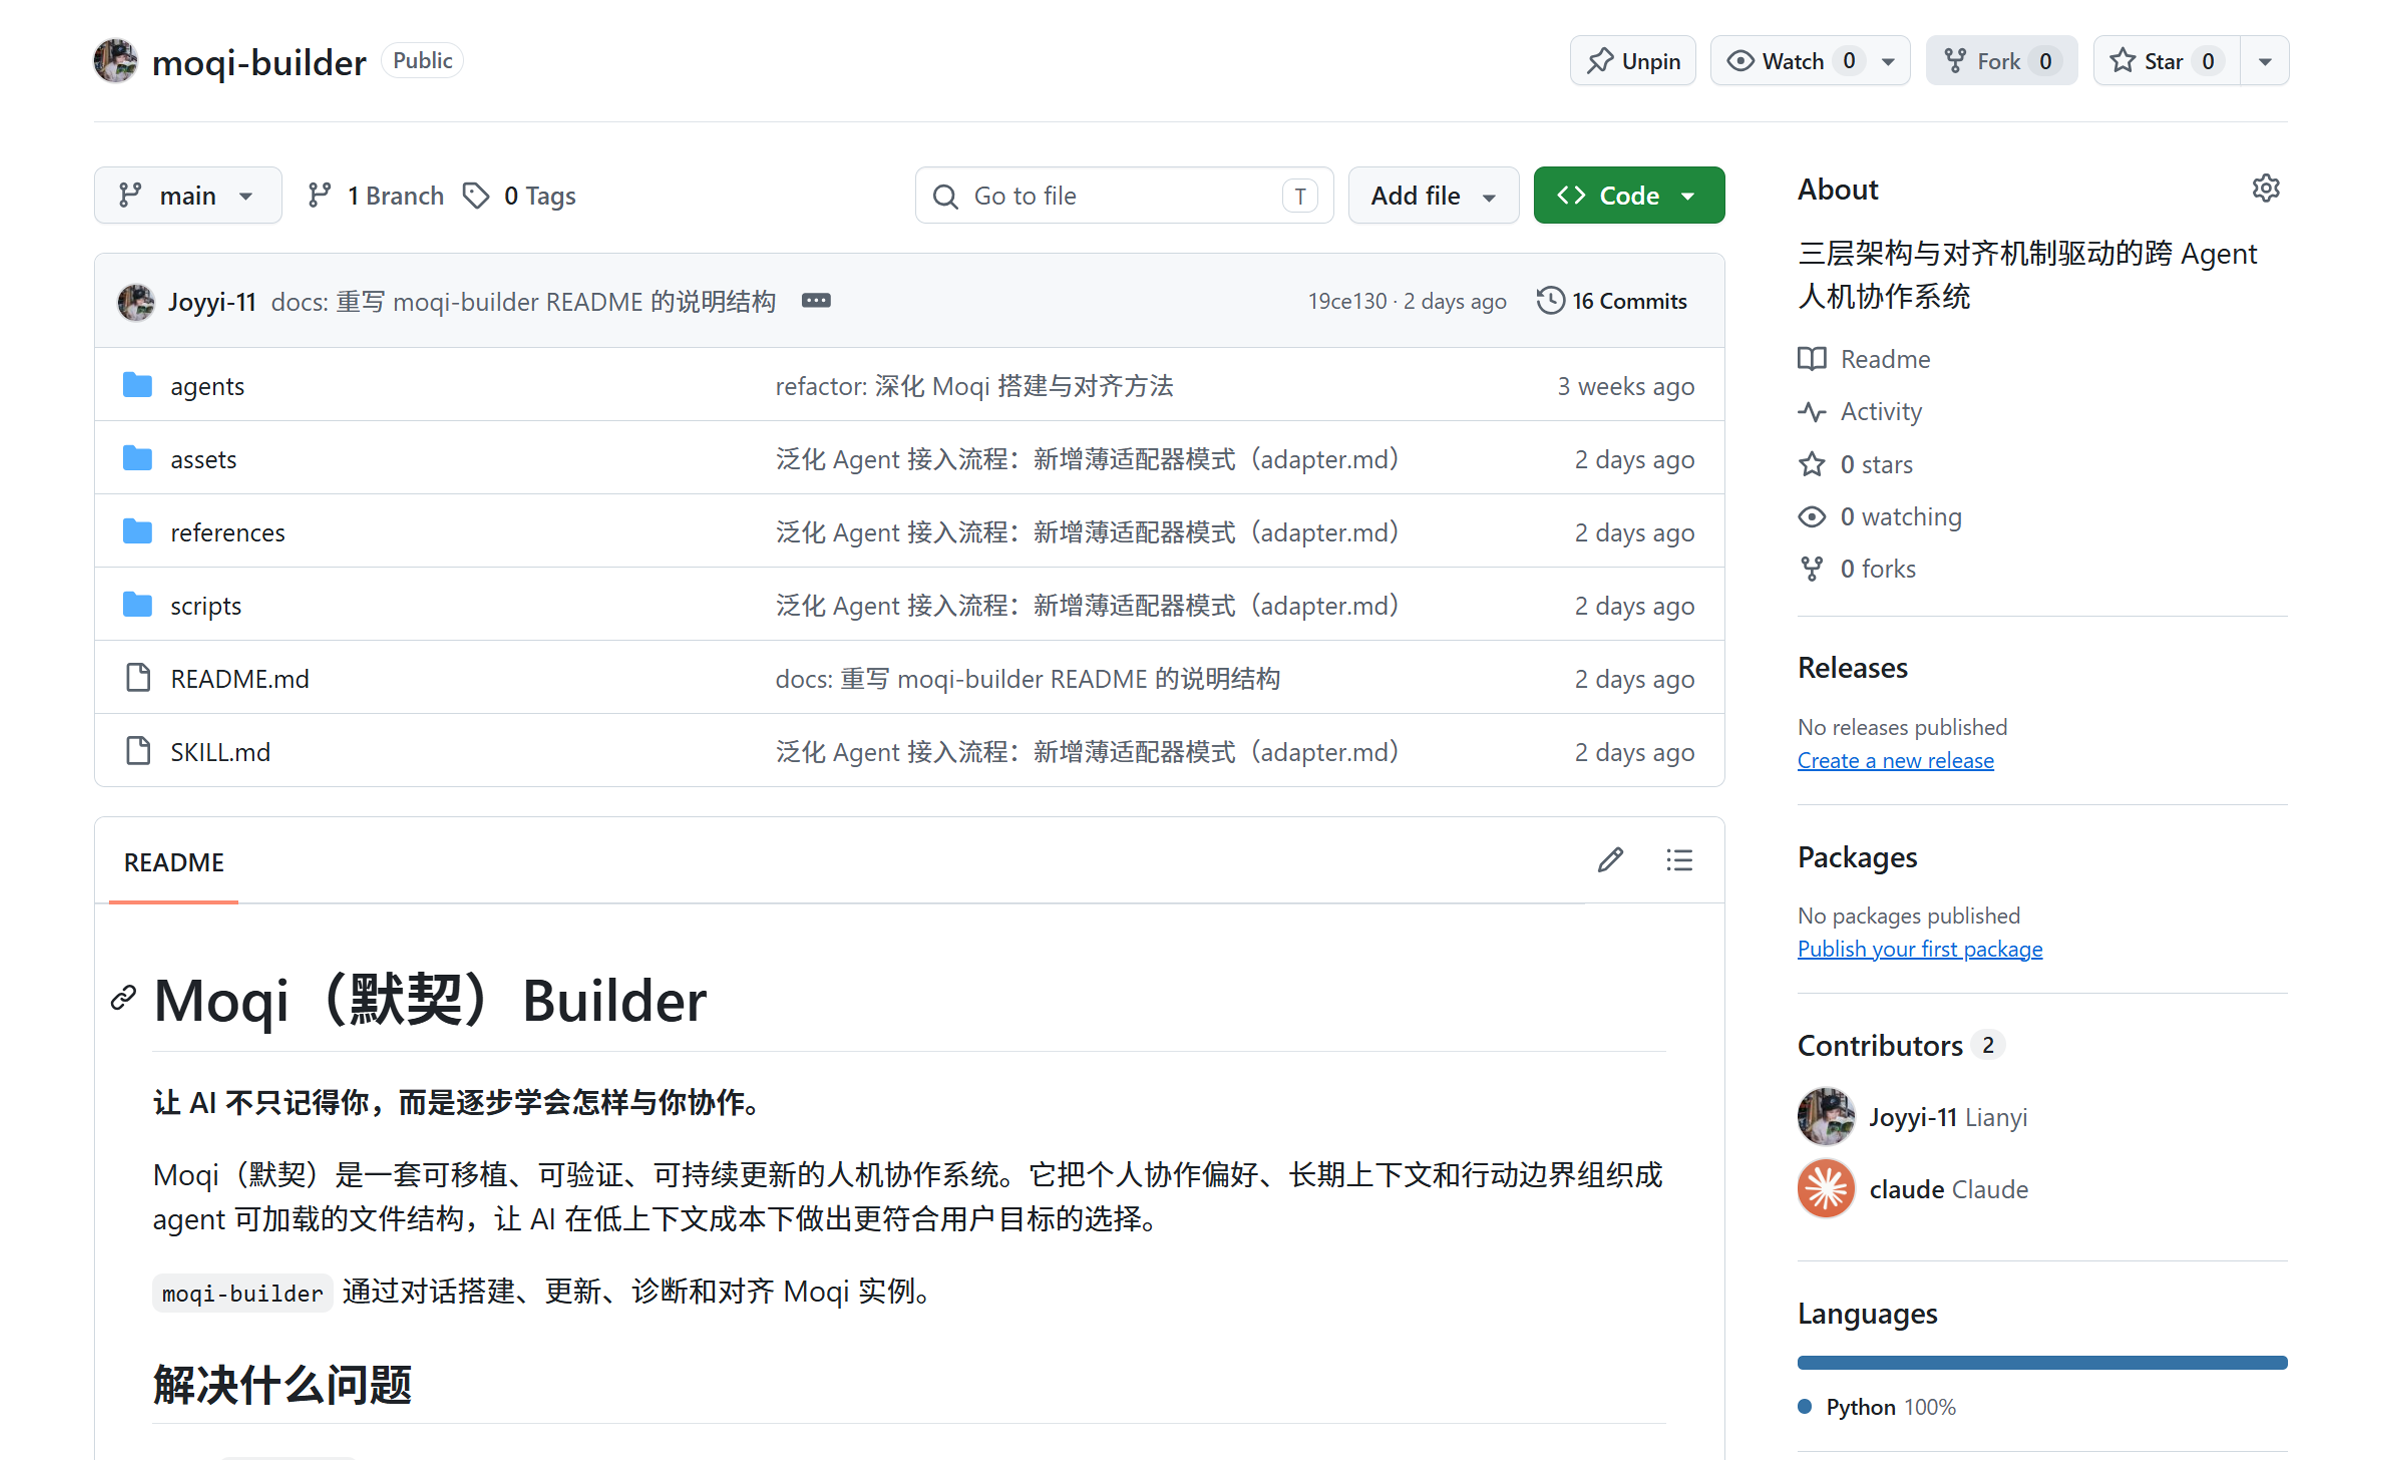
GitHub: https://github.com/Joyyi-11/moqi-builder
局限与下一步
当前验证主要来自个人长期使用与公开文章传播。这能够证明我可以从模糊摩擦中界定问题、设计结构、说清取舍并承认边界,但跨用户的系统性可用性,尤其是「可理解、可接入、可长期维护」,仍待结构化验证。
下一步招募 5~8 位有多 Agent 使用经验的重度 AI 用户,至少完成 5 次完整试用,重点验证分层加载与「对齐」机制是否可理解、可接入、可长期维护。