撷声 Xiesheng|把小宇宙播客转录为结构化文稿
本地转写结合大模型校订,平衡质量、速度与成本
为什么做
小宇宙自身的会员服务只有内容概要、速览亮点和章节大纲,没有我想要的导出文稿和说话人区分等功能。市面上的播客转录服务通常按月订阅,最低档也要约 70 元/月。对于不定期转录的我来说,为几集付一整份订阅费是明显的价格错配。同样的金额,换成按需调用大模型 API,可以用很久。
我对 12 款国内外转录工具的市场调研进一步印证了这一点:订阅制对于低频用户是明确的价格错配,而「低成本、校订干净的完整稿」在市面上没有直接对标物。调研报告
目标
市面工具要么贵、要么需要自己再加工。我想要解决的问题是,如何低成本且高质量地得到播客转录文稿,在准确率、处理速度与付费成本之间取得平衡。
运行机制
整套链路由四个模块协作:抓取模块负责小宇宙节目元信息与音频,转录模块在本地完成转写与说话人区分,校订模块把长文分块交给 LLM,渲染模块按固定结构组装 Markdown。各阶段产物独立保存,原始转录可回查;分块缓存按来源、模型和提示词版本隔离,单块失败回退原稿,遇到限流退避重试,断点可续跑;支持 API 与会话内两种后处理链路。
关键判断
确立「本地转写 + 大模型校订」的项目架构
语音识别和语义理解应分别由不同的能力承担。语音识别需要处理长音频和本地算力,语义整理则需要理解专名、上下文和内容结构。我采用本地 ASR 模型完成转写(免费),仅将文本校订和内容提炼交给 LLM(按量付费),从根源上解耦成本与质量。原始转录始终独立保存,模型只作为辅助整理工具。
通过对比实验完成技术选型
最初我基于 GitHub 开源项目选用 Faster-Whisper 模型,实测发现,中文播客场景下准确率和速度不足。于是我重新做技术选型,用 Faster-Whisper Medium、SenseVoice-Small、Paraformer-Large 分别转写同一期播客。基于速度和质量,我最终选定 SenseVoice-Small 作为本地转写底座。说话人区分同样经实测对比后,采用 SenseVoice 自带的说话人模型一站式产出标签,从 Show Notes 解析说话人数并强制聚类,避免独立说话人模块与转录文本对不齐。实验报告
机械格式交给脚本,语义理解交给大模型
直接让 LLM 校订全文,它有时候会篡改专有名词、语句等,输出质量不稳定且调用成本高。我的解决方案是分层处理:脚本规则兜底断句、数字、特殊符号等确定性任务,LLM 负责处理上下文一致性、口语化表达和专业术语纠错等语义理解类任务。二者各司其职,保证质量,降低成本。同时,我在长链路处理中设置了分块缓存、失败回退和断点续跑机制,避免因单点故障从头再来。
当前结果
实测单集播客,转录与校订耗时从原来的 1-2 小时缩短到 10-20 分钟(约原耗时的 1/6),单期 API 成本不超过 0.1 元。
关键迭代节点:
- 转写准确率低 → 将 Faster-Whisper Tiny 改为 Small,再切换到 Medium,叠加 LLM 校订,完善项目脚本
- 原始转录混乱 → 增加说话人区分与固定输出结构(Show Notes / 摘要 / 核心观点 / 问题与思考 / 人物简介 / 原文转录)
- 长链路失败中断 → 分块缓存、失败回退、限流退避、断点续跑
- 转写慢、中文繁简混杂 → 用三模型基准对比后,选定 SenseVoice-Small 并移除 Faster-Whisper
- 自动校订依赖 API → 增加会话内校订链路,两条路径校订规则一致,产出同构
- 转录文稿语病多 → 强化 LLM 校订提示词
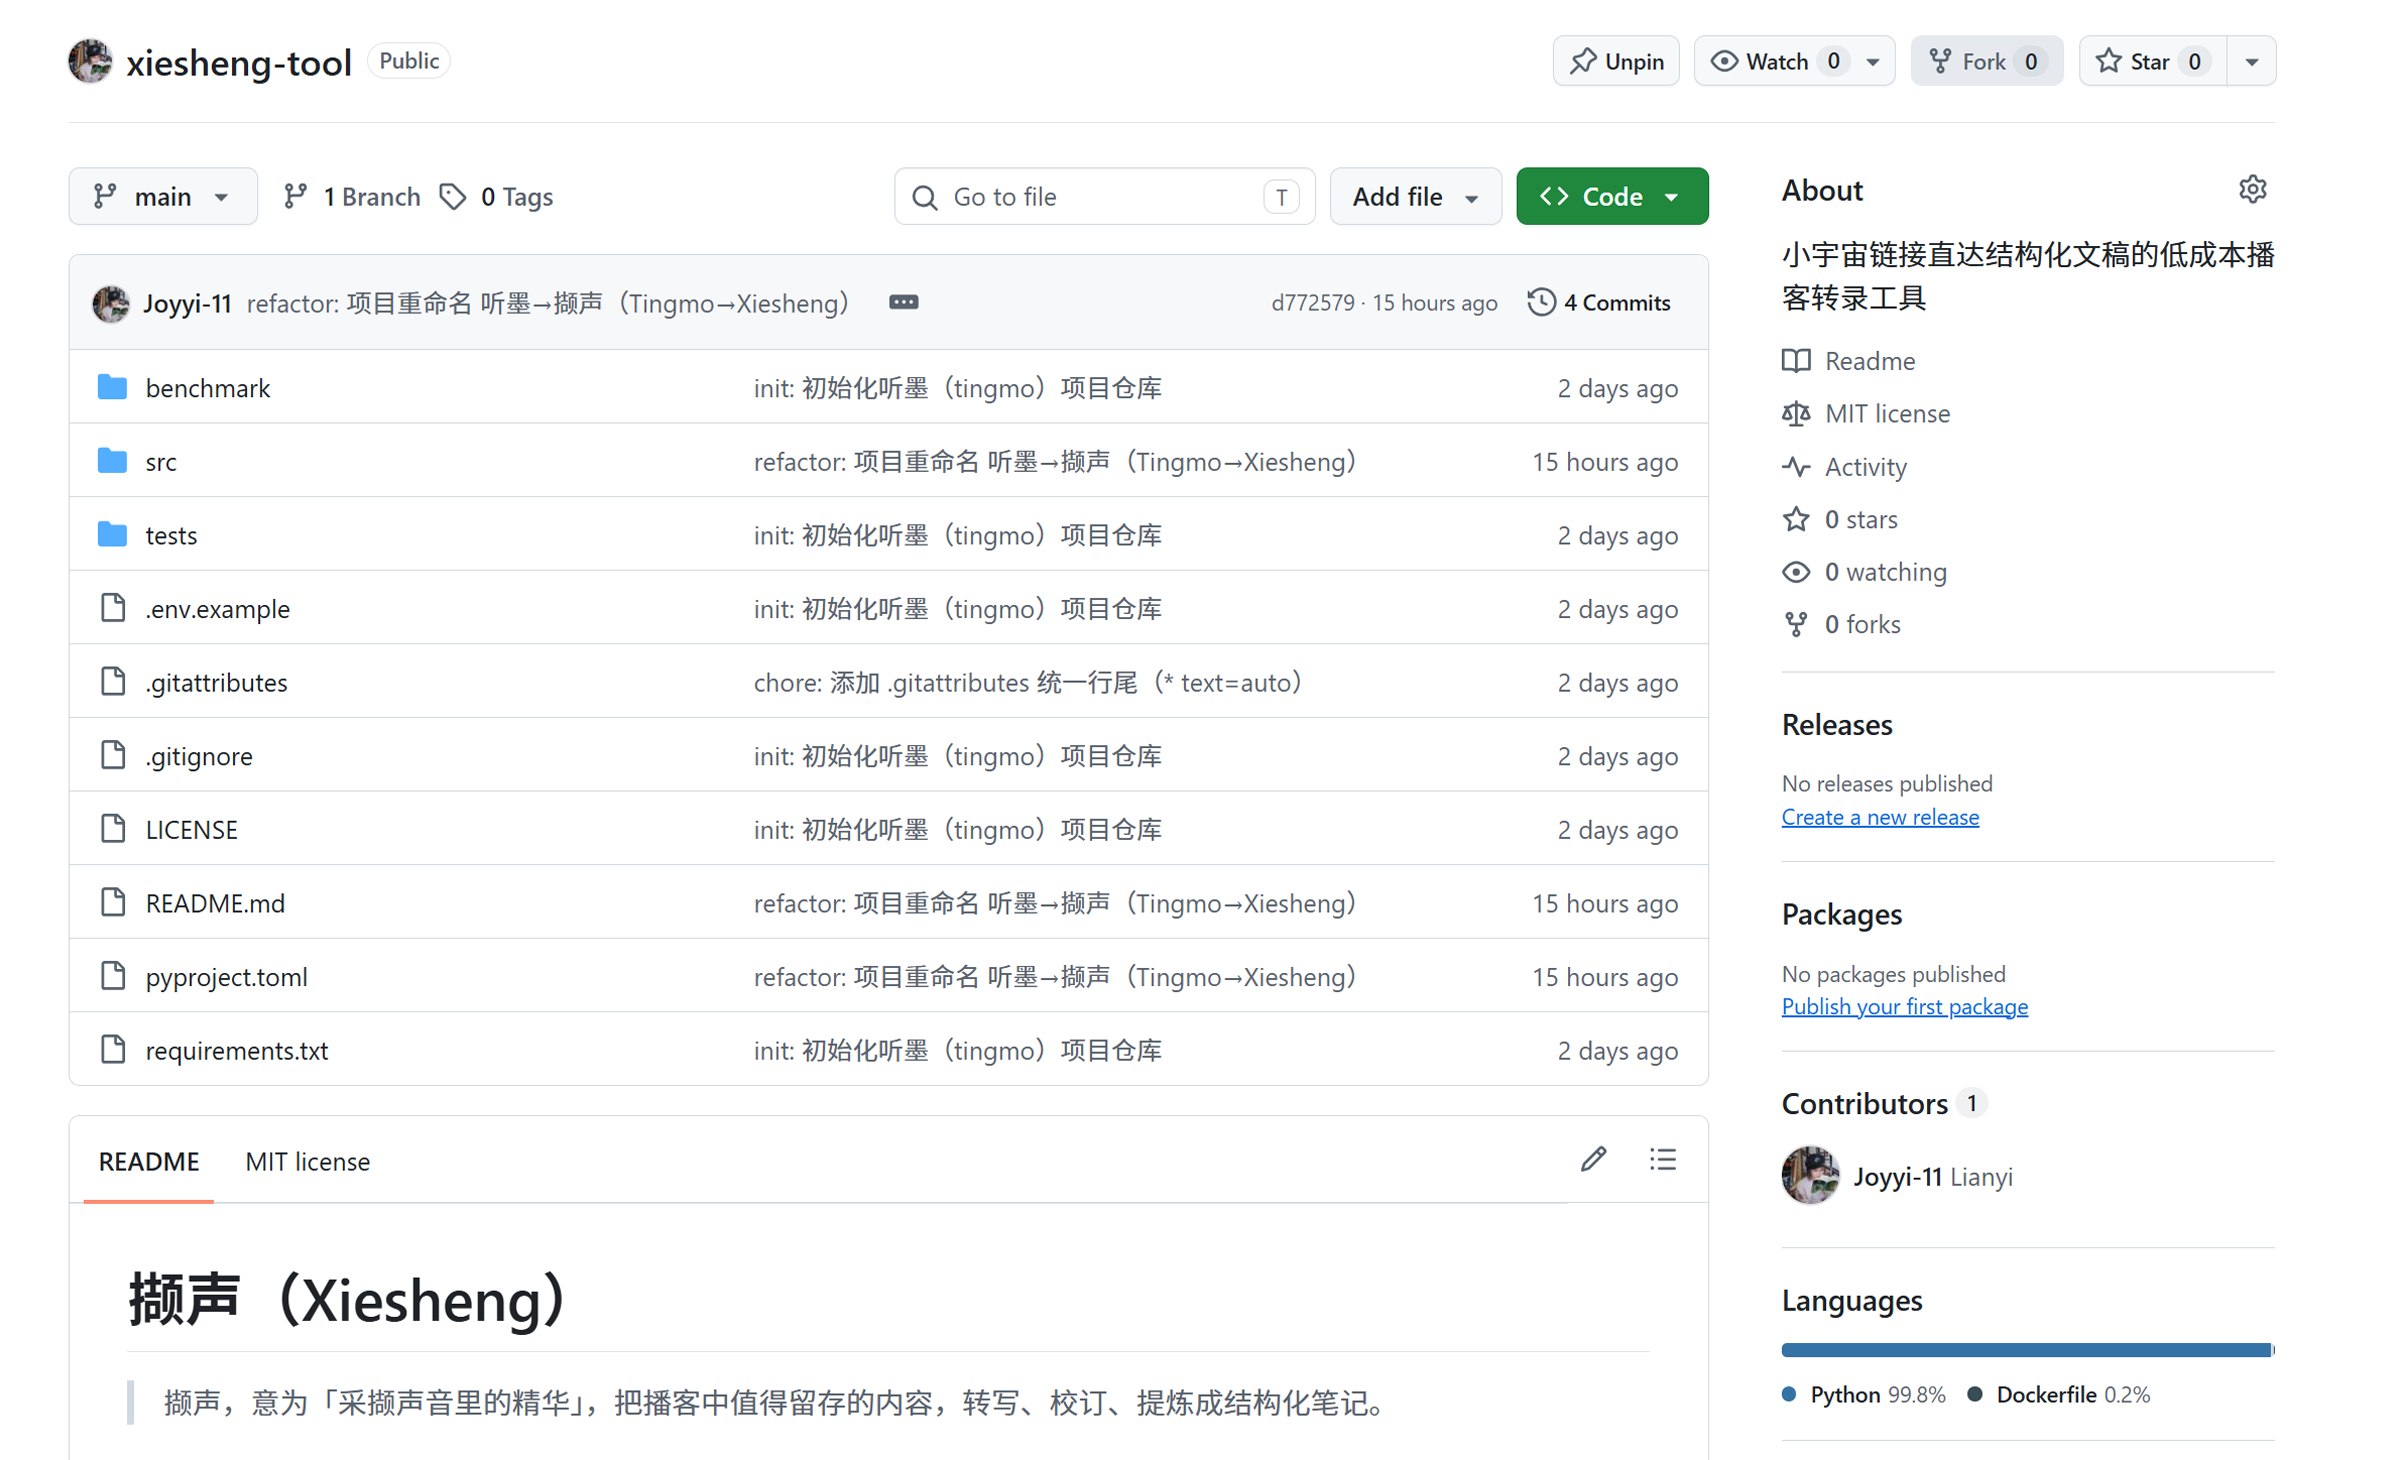
GitHub: https://github.com/Joyyi-11/xiesheng-tool
局限与下一步
当前主要支持小宇宙,依赖本地转写模型(SenseVoice-Small)与 Python 环境;页面结构变化可能影响抓取,说话人身份仍需人工复核。最大外部风险是小宇宙官方补齐转录/摘要能力或收紧反爬,因此在架构上把「小宇宙抓取」隔离为可替换适配层,保留 RSS/本地音频入口作为逃生通道。
下一步计划邀请少量重度播客用户验证安装成本、异常提示与输出可用性,重点验证外部用户能否低门槛稳定使用。
个人思考
这个项目是我与AI深度协作的实践。在开发阶段,我负责定义架构与把控方向:前期使用 Codex + GPT-5.6 搭建项目框架、设计核心模块接口;项目架构稳定后,切换至 WorkBuddy 处理日常维护和优化任务。在后续使用阶段,我会把真实转录场景中暴露的问题,比如转录速度慢、简繁混杂、长链路偶发中断等,整理为优化需求反馈给 AI,让它帮我执行代码层面的修改和迭代。模型选型、链路重构这类需要判断的决策,则由我主导完成。
通过这个项目,我深刻体会到,人与 AI 应该分工协作,各自做擅长的事情。我负责问题定义,AI 负责执行。当我把目标、边界和容错机制这些都定义清晰后,AI 才能成为高效的执行者,帮我把想法落地。同时,我的实测反馈成为 AI 进一步迭代项目的基础。我始终作为主导者,确保整个系统朝着我期望的方向前进。